
Table of Contents
Die Generation einer GPU bestimmt, in welchen Zahlenformaten (Genauigkeiten) sie KI-Berechnungen am schnellsten ausführt, welche Speicherbandbreite sie bietet und wie viel Energie sie benötigt. Im Angebot professioneller GPUs von NVIDIA sind drei Generationen vertreten: Ampere (z. B. RTX A6000), Ada Lovelace (z. B. RTX 6000 Ada) und Blackwell (z. B. RTX PRO 6000 Blackwell). Jede neue Generation unterstützt niedrigere Rechengenauigkeiten – von BF16 bei Ampere bis FP4 bei Blackwell.
Die Wahl der Generation hängt von Modellgröße, Rechenformat, Nutzerzahl und den Betriebsbedingungen der Hardware ab. GPU-Typen, VRAM, OEM-, Retail- und Bulk-Varianten erläutern wir in der Kategorie GPUs für KI. Dieser Artikel konzentriert sich auf Unterschiede zwischen den Generationen und Editionen. Er richtet sich an IT-Leiter, Infrastrukturarchitekten, Data-Science-Teams und Beschaffungsverantwortliche, die GPUs für KI-Projekte im Unternehmen auswählen.
GPU-Generation von NVIDIA anhand der Kartenbezeichnung erkennen
Die Generation einer GPU von NVIDIA lässt sich an der Modellbezeichnung erkennen. Die Zahl im Namen (z. B. 2000, 4000, 6000) kennzeichnet die Leistungsklasse der Karte innerhalb einer Generation: Je höher die Zahl, desto mehr Kerne und Speicher. Daher trägt dieselbe Klasse in aufeinanderfolgenden Generationen unterschiedliche Namen, z. B.: RTX A6000 (Ampere), RTX 6000 Ada (Ada Lovelace) und RTX PRO 6000 Blackwell (Blackwell).
| Generation | Jahr | GPUs für Workstations | GPUs für Server | Beispiele im Sortiment |
|---|---|---|---|---|
| Blackwell | 2025 | RTX PRO + Zahl + Blackwell | RTX PRO + Zahl + Blackwell Server Edition | RTX PRO 2000 Blackwell |
| Ada Lovelace | 2022 | RTX + Zahl + Ada | L + Zahl | L4 |
| Ampere | 2020 | RTX A + Zahl | A + Zahl | RTX A1000 |
Was sich zwischen den Generationen bei KI-Aufgaben ändert
Die Generationen unterscheiden sich vor allem durch unterstützte Rechengenauigkeiten, Speicherbandbreite und Leistungsaufnahme.
Die wachsende Bedeutung niedrigerer Genauigkeiten bestätigt der Bericht AI Index 2026 der Stanford University: Berechnungen in Formaten mit reduzierter Genauigkeit sind bei vielen Anwendungen sowohl für das Training als auch für die Inferenz von Modellen zum Standard geworden. Laut den Autoren des Berichts führt modernste Hardware für maschinelles Lernen heute etwa 10-mal mehr Berechnungen pro Watt aus als vor einem Jahrzehnt. Jede neue GPU-Generation verschiebt diese Grenze weiter: Ampere beschleunigt Berechnungen in BF16, Ada Lovelace ergänzte FP8, und Blackwell – FP4 und FP6.
Die folgende Übersicht vergleicht drei GPUs derselben Leistungsklasse (6000).
| Parameter | RTX A6000 (Ampere) | RTX 6000 Ada (Ada Lovelace) | RTX PRO 6000 Blackwell Workstation Edition |
|---|---|---|---|
| Generation der Tensor-Kerne | 3. | 4. | 5. |
| Durch Tensor-Kerne beschleunigte Genauigkeiten | TF32, BF16, FP16, INT8 | wie Ampere + FP8 | wie Ada + FP6, FP4 |
| Speicher | 48 GB GDDR6 | 48 GB GDDR6 | 96 GB GDDR7 |
| Speicherbandbreite | 768 GB/s | 960 GB/s | 1792 GB/s |
| Tensor-Leistung FP16 | 154,8 TFLOPS | 364 TFLOPS | 503,8 TFLOPS |
| Leistungsaufnahme (TGP) | 300 W | 300 W | 600 W |
| Schnittstelle | PCIe 4.0 | PCIe 4.0 | PCIe 5.0 |
Ampere
Ampere (2020) führte die dritte Generation der Tensor-Kerne sowie die Formate TF32 und BF16 ein, die häufig beim Modelltraining eingesetzt werden. GPUs dieser Generation beschleunigen FP8-Berechnungen nicht hardwareseitig. Höhere Workstation-Modelle der RTX-A-Serie, etwa RTX A6000, unterstützen NVLink-Brücken zur Verbindung von zwei Karten. Die kompakten RTX A1000 und RTX A400 eignen sich für Arbeitsplätze mit geringer Leistungsaufnahme.
Ada Lovelace
Ada Lovelace (2022) brachte die vierte Generation der Tensor-Kerne mit Unterstützung für FP8, wodurch der Speicherbedarf sinkt und laut Hersteller eine bis zu 4-mal höhere Inferenzleistung als die vorherige Generation erreicht wird. Zu dieser Generation gehören RTX-Ada-Workstation-Karten sowie die Serverbeschleuniger L4, L40 und L40S.
Blackwell
Blackwell (RTX-PRO-Serie ab 2025) führt die fünfte Generation der Tensor-Kerne mit Unterstützung für FP4 und FP6 sowie GDDR7-Speicher ein. Laut NVIDIA benötigt ein Modell in FP4 weniger als die Hälfte des Speichers, der in FP16 erforderlich ist. Nach Herstellerangaben erzeugt die RTX PRO 6000 Blackwell ein Bild mit dem Modell FLUX.dev in ca. 7 s in BF16 und in 3,3 s in FP4.
Wann eine GPU der Blackwell-Generation die richtige Wahl ist
Die Blackwell-Generation eignet sich gut für Unternehmen, die große Modelle auf einer einzelnen Karte ausführen, FP4-Quantisierung nutzen oder eine Karte auf mehrere Teams aufteilen möchten. Diese Möglichkeiten ergeben sich aus konkreten Merkmalen der Architektur:
- Unterstützung für FP4 und FP6 – die niedrigere Genauigkeit ermöglicht die Ausführung eines größeren Modells im selben Speicher und beschleunigt die Inferenz. Tensor-Kerne der fünften Generation verarbeiten FP4 mit doppelt so hoher Bandbreite wie FP8.
- GDDR7-Speicher – der neuere Speicherstandard bietet eine höhere Bandbreite als GDDR6. Die Spitzenmodelle dieser Generation verfügen über doppelt so viel Speicher und eine doppelt so hohe Bandbreite wie ihre Pendants der vorherigen Generation.
- MIG (Multi-Instance GPU) – eine Karte kann in mehrere isolierte Instanzen aufgeteilt werden. Jede verfügt über eigenen Speicher und Rechenkerne, sodass mehrere Aufgaben oder Teams parallel arbeiten, ohne die Leistung der jeweils anderen zu beeinträchtigen.
- PCIe 5.0 – die doppelt so hohe Busbandbreite gegenüber PCIe 4.0 beschleunigt den Datenaustausch mit Prozessor und Systemspeicher.
- Breite Auswahl an Leistungsklassen – die RTX-PRO-Serie umfasst sowohl kompakte Karten für kleine Gehäuse als auch Modelle mit hoher Speicherkapazität für anspruchsvollste Aufgaben.
Bei der Konfigurationsplanung sollte die Leistungsaufnahme berücksichtigt werden: Die RTX PRO 6000 Blackwell Workstation Edition benötigt bis zu 600 W und damit doppelt so viel wie die RTX 6000 Ada. Dies beeinflusst die Auswahl von Netzteil und Kühlung sowie bei mehreren Karten die Wahl der Editionen, die wir im weiteren Verlauf des Artikels beschreiben.
Wann eine GPU-Karte der Generation Ampere oder Ada Lovelace die Anforderungen erfüllt
GPU-Karten der Generationen Ampere und Ada Lovelace eignen sich gut für die Anforderungen eines Unternehmens, wenn das Modell in ihren Speicher passt und die Arbeitsumgebung Formate nutzt, die von diesen Generationen beschleunigt werden. Dies betrifft meist die folgenden Situationen:
- Modelle in den Formaten FP16 und BF16 – beide Formate werden von den Tensor-Kernen aller drei Generationen beschleunigt. Plant das Unternehmen keine Quantisierung auf FP8 oder FP4, kann die Ampere-Generation dieselben Modelle verarbeiten.
- Inferenz in FP8 – die Ada-Lovelace-Generation unterstützt FP8 hardwareseitig. In dieser Generation sind zudem energieeffiziente Serverbeschleuniger für Inferenz und Videobearbeitung verfügbar.
- Erweiterung der bestehenden Infrastruktur – die Beschaffung weiterer Karten derselben bereits eingesetzten Generation erleichtert die einheitliche Verwaltung von Treibern, System-Images und Prozessen.
- Verbindung von zwei Karten in einer Workstation über eine NVLink-Brücke – bei Workstation-Karten wird dies von höheren Modellen der RTX-A-Serie (Ampere) unterstützt.
- Virtualisierung und gemischte Workloads – Serverbeschleuniger der Ada-Lovelace-Generation kombinieren Inferenz mit virtuellen Workstations und Videobearbeitung.
- Kompakte Arbeitsplätze – Low-Profile-Karten der Generationen Ampere und Ada Lovelace passen in kleine Gehäuse und eignen sich für weniger anspruchsvolle Modelle.
Vor dem Kauf sollte geprüft werden, ob die verwendeten Bibliotheken und KI-Frameworks die gewählte Generation in der erforderlichen CUDA-Version unterstützen.
Gleiche Generation, verschiedene Editionen – am Beispiel der RTX PRO 6000 Blackwell
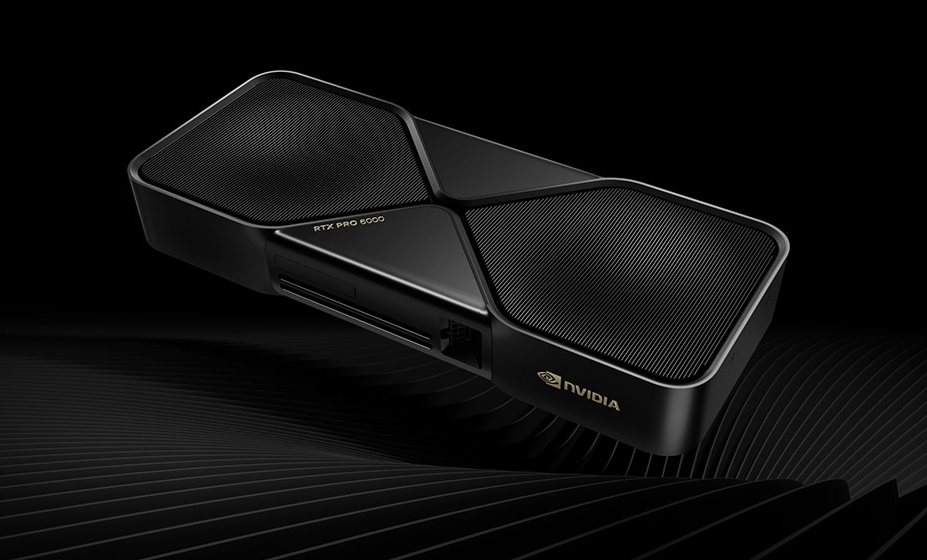
Innerhalb einer Generation kann dasselbe GPU-Kartenmodell in mehreren Editionen erhältlich sein. Die RTX PRO 6000 Blackwell ist in drei Editionen verfügbar: Workstation Edition, Max-Q Workstation Edition und Server Edition. Alle nutzen denselben GB202-Chip und verfügen über 96 GB GDDR7-Speicher. Sie unterscheiden sich in Kühlung, Leistungsgrenze und Einbauumgebung.
| Parameter | Workstation Edition | Max-Q Workstation Edition | Server Edition |
|---|---|---|---|
| Kühlung | aktiv, 2 Lüfter | aktiv, 1 Lüfter | passiv (Kühlkörper) |
| Leistungsaufnahme | bis zu 600 W | 300 W | bis zu 600 W (konfigurierbar) |
| Kartenlänge | 304,8 mm | 266,7 mm | 266,7 mm |
| Speicherbandbreite | 1792 GB/s | 1792 GB/s | 1597 GB/s |
| Videoausgänge | 4 × DisplayPort 2.1b | 4 × DisplayPort 2.1b | 4 × DisplayPort 2.1 |
| Einsatzbereich | Workstation | Workstation, auch mit mehreren Karten | Server mit Zwangsbelüftung |
| Beispiel im Sortiment | NVIDIA 900-5G144-2500-000 | NVIDIA 900-5G153-2500-000 | PNY TCSRTXPRO6000SE-BLK |
Workstation Edition
Die Workstation Edition arbeitet mit der vollen Leistungsgrenze von 600 W und verfügt über zwei eigene Lüfter, die Wärme von der Karte abführen. Diese Edition ist für Workstations mit einer GPU-Karte ausgelegt, bei denen die maximale Leistung eines einzelnen Prozessors entscheidend ist.
Max-Q Workstation Edition
Die Max-Q Workstation Edition arbeitet mit einer Leistungsgrenze von 300 W, also halb so hoch, bei gleicher Speicherkapazität und Speicherbandbreite. Die geringere Leistungsaufnahme bedeutet weniger Wärme, die aus dem Gehäuse abgeführt werden muss. In einer Workstation lassen sich bis zu vier Karten dieser Edition installieren, was insgesamt 384 GB GPU-Speicher ergibt.
Server Edition
Die Server Edition hat keine Lüfter. Die Wärme wird durch den von den Serverlüftern erzeugten Luftstrom abgeführt. Daher ist diese Edition für Server mit Zwangsbelüftung und nicht für Workstation-Gehäuse vorgesehen. Diese Karten sind für den Dauerbetrieb in Rechenzentren optimiert und unterstützen unter anderem Secure Boot sowie Confidential Computing.
Dieselbe Einteilung in Editionen gilt auch für andere Modelle der RTX-PRO-Blackwell-Serie.
GPU-Generation und -Edition im Verhältnis zur KI-Aufgabe
Die Auswahl einer GPU-Karte beginnt mit der Aufgabe, die sie ausführen soll: Das Prototyping an einem einzelnen Arbeitsplatz stellt andere Anforderungen als Inferenz für ein ganzes Team oder das Training großer Modelle. Die folgende Tabelle ordnet typische KI-Aufgaben im Unternehmen der GPU-Generation und -Edition zu, die ihre Anforderungen erfüllen.
| KI-Aufgabe | Generation | Edition oder Formfaktor | Beispiele im Sortiment |
|---|---|---|---|
| Prototyping und Tests kleinerer Modelle an einem einzelnen Arbeitsplatz | Ada Lovelace oder Blackwell | Workstation, kompakte Karte | RTX PRO 4000 SFF Blackwell |
| Modelle in FP16 oder BF16, Erweiterung von Workstations mit Ampere-Karten | Ampere | Workstation | RTX A1000 |
| Lokales Sprachmodell für ein Team, Inferenz in FP8 | Ada Lovelace | Workstation | RTX 6000 Ada |
| Großes Modell auf einer Karte, Quantisierung FP4 | Blackwell | Workstation Edition | RTX PRO 6000 Blackwell Workstation Edition |
| Mehrere GPU-Karten in einer Workstation | Blackwell | Max-Q Workstation Edition | RTX PRO 6000 Blackwell Max-Q |
| Inferenz auf einem Server bei geringer Leistungsaufnahme, Videobearbeitung | Ada Lovelace | Low-Profile-Serverbeschleuniger | L4 |
| Multimodale Inferenz auf einem Server, Aufteilung einer Karte zwischen Teams (MIG) | Blackwell | Server Edition | RTX PRO 6000 Blackwell Server Edition |
Die Auswahl des gesamten Systems erläutern wir in separaten Artikeln: So wählen Sie einen Computer für KI aus, So wählen Sie einen Server für KI aus und Wann ein Sprachmodell auf eigener Hardware betrieben werden sollte.
Häufig gestellte Fragen zu GPU-Generationen für KI
Eine neuere Generation bietet eine höhere Spitzenleistung und Unterstützung für niedrigere Präzisionen, doch der Nutzen hängt von der Aufgabe ab. Wenn ein Modell in FP16 oder BF16 läuft und in den Grafikspeicher passt, wird es von GPU-Karten aller drei Generationen (Ampere, Ada Lovelace, Blackwell) hardwareseitig beschleunigt. Der größte Unterschied zeigt sich bei auf FP8 oder FP4 quantisierten Modellen sowie bei Modellen mit hohem Speicherbedarf.
Es handelt sich um GPUs derselben Leistungsklasse aus drei aufeinanderfolgenden Generationen. RTX A6000 (Ampere) und RTX 6000 Ada verfügen jeweils über 48 GB GDDR6 Speicher und eine Leistungsaufnahme von 300 W. RTX PRO 6000 Blackwell bietet 96 GB GDDR7 Speicher mit einer Bandbreite von 1792 GB/s und unterstützt als einzige von ihnen FP4.
Ja. GPUs der Ampere-Generation beschleunigen Berechnungen in den Formaten TF32, BF16 und FP16, die beim Training und bei der Inferenz vieler Modelle eingesetzt werden. Das Format FP8, das von den Generationen Ada Lovelace und Blackwell unterstützt wird, beschleunigen sie nicht in Hardware.
Die Genauigkeit bezeichnet das Format, in dem die Zahlen eines Modells gespeichert werden, etwa FP16, FP8 oder FP4. Je weniger Bits verwendet werden, desto weniger Speicher belegt das Modell und desto schneller läuft es. Die Ergebnisqualität bei geringerer Genauigkeit hängt von der verwendeten Quantisierungsmethode ab.
FP4 ist ein 4-Bit-Zahlenformat, bei dem ein Modell weniger als die Hälfte des Speichers benötigt, der bei FP16 erforderlich ist. Tensor Cores der fünften Generation verarbeiten FP4 mit doppelt so hoher Bandbreite wie FP8. Dadurch lässt sich ein größeres Modell auf einer einzelnen GPU betreiben oder die Inferenz beschleunigen.
Für Workstations ausgelegte Karten mit der Bezeichnung RTX A gehören zur Ampere-Generation, Karten mit dem Zusatz Ada zur Generation Ada Lovelace und die RTX-PRO-Serie mit dem Zusatz Blackwell zur Blackwell-Generation. Bei Serverbeschleunigern gibt der erste Buchstabe der Bezeichnung die Generation an: A steht für Ampere, L für Ada Lovelace.
Alle drei Editionen verfügen über denselben Chip und 96 GB GDDR7 Speicher. Die Workstation Edition arbeitet mit einer Leistungsaufnahme von bis zu 600 W und aktiver Kühlung, Max-Q mit einer Leistungsaufnahme von 300 W und aktiver Kühlung, während die Server Edition über eine passive Kühlung für Server mit Zwangsbelüftung verfügt.
Ja, sofern die Karte die MIG-Technologie (Multi-Instance GPU) unterstützt. RTX PRO 6000 Blackwell lässt sich in bis zu vier isolierte Instanzen mit jeweils 24 GB aufteilen, die jeweils über eigenen Speicher und eigene Rechenkerne verfügen.
